Agent 说「做完了」真的可信吗?
Peter,也就是 OpenClaw 作者,前两天在推特上发了一个帖子,热度拉满:
大量使用 Codex 和 Claude Code 的 Goal 循环、踩过 N 次坑后,我只好摸索下一代 Agent 循环框架。
Flow 从开发之初便前瞻性使用图结构设计。显著避免了前者开放循环的问题:模型自己决定下一步做什么,什么时候算完成,在复杂任务中非常容易翻车。
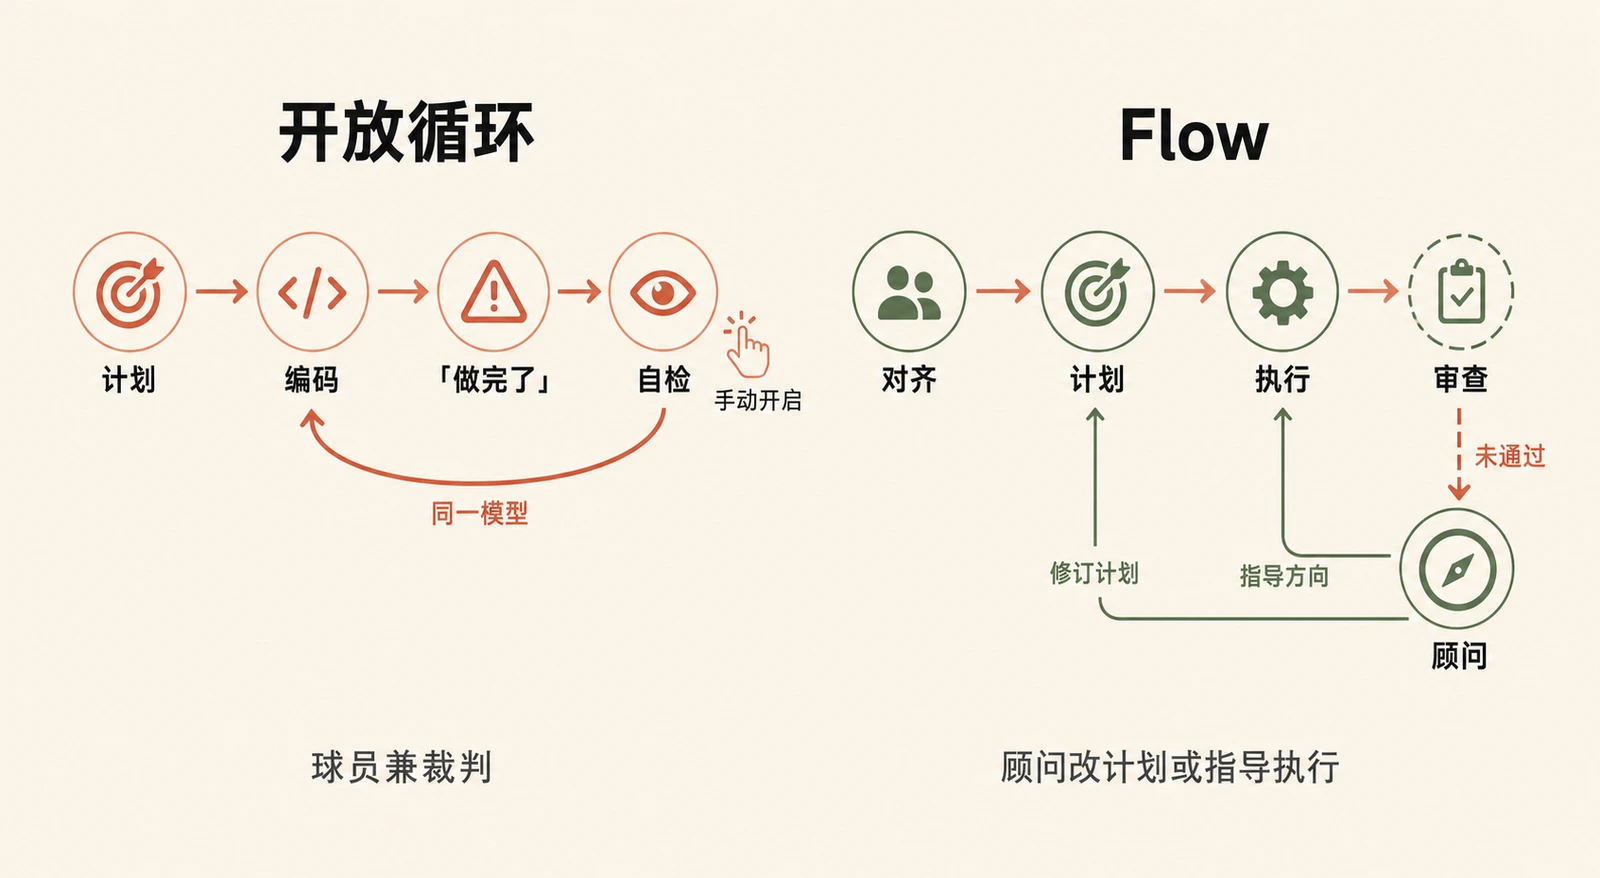
很多人都有用过 Agent 来做项目。简单任务下使用 Goal 循环,没感到不妥;但当涉及到大型代码库或复杂任务时便会有所体会。
比如:你说了你想做的,模型就开始吭哧吭哧干,模型不会逼问你,但模型也没有真正 Get 到你的期望,就根据权重中的相似想法,猜测着干。
最终效果令人失望:要么模型说做完了,实际上功能并未完整实现,或是质量差。又比如使用了 Codex 或 Claude Code 自带的 review 功能,但效果参差不齐。
这实际上是有几个原因的。
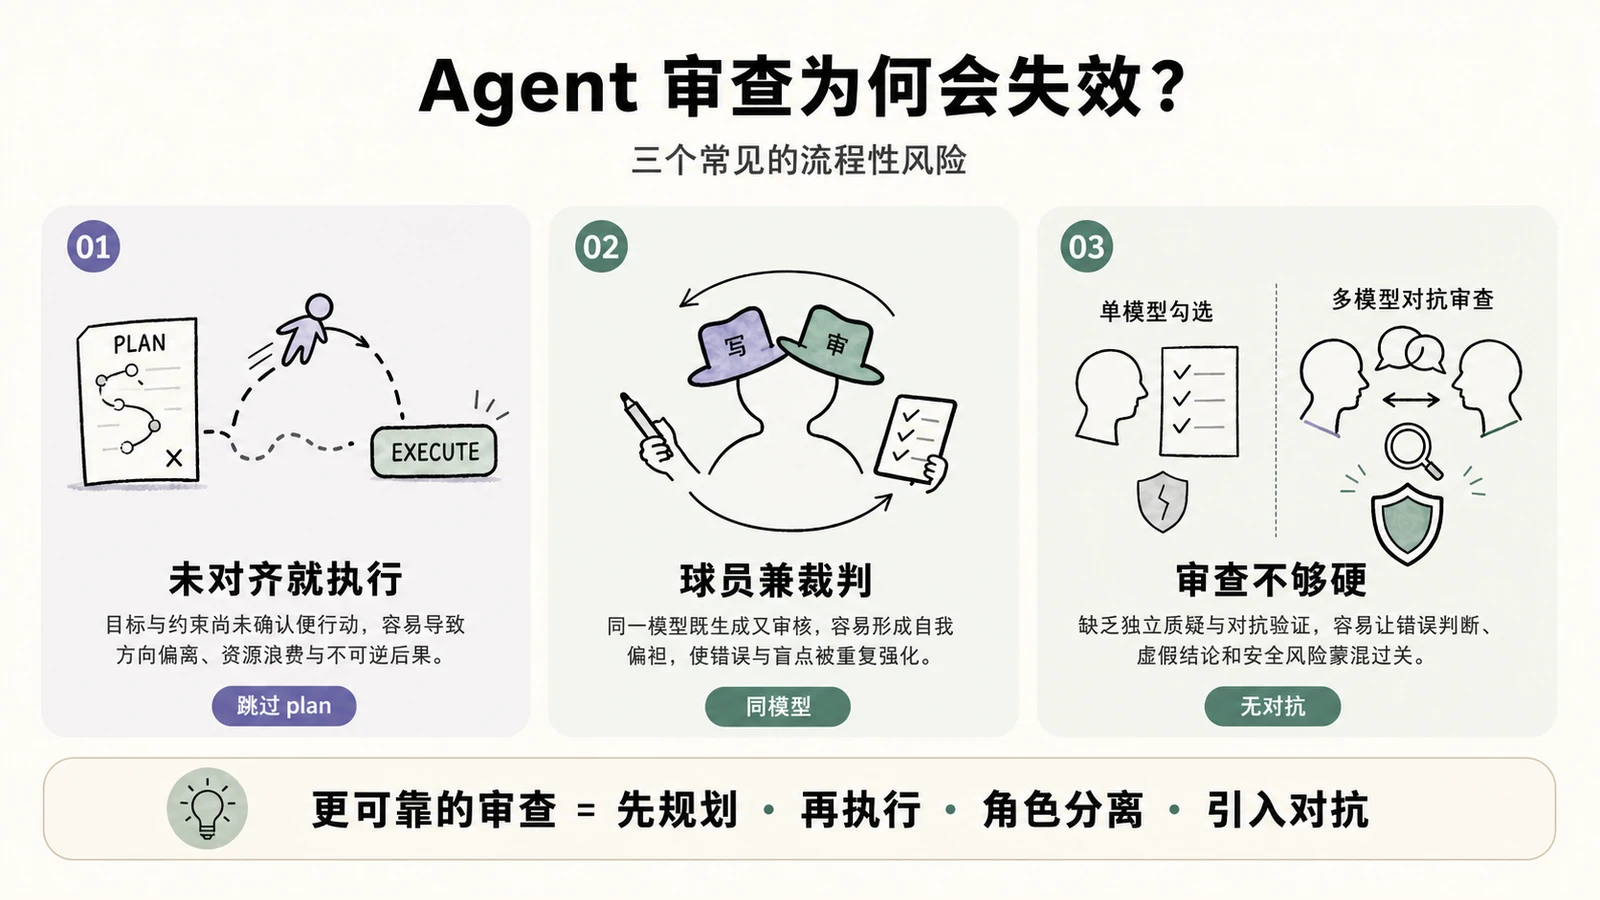
一:你跟模型之间的思路其实没有完全对齐,但由于厂商想让 Agent 看起来更加智能、能够从头到尾做完一个很长的任务,harness 会要求它们更加笃定的端到端执行(详见 Codex 系统提示词),所以可能会忽视与你的对齐——除非你激活了对应的 skills,或者是主动打开 plan 模式(这是一个好习惯)。
二:普通 Coding Agent 的 review 在设计上有一定局限性:有的 review 是同一个模型自己裁决,失去了公正性;要么就是他们只遵循 Git diff,而不是本次会话修改的内容,可能导致开发习惯不好的用户(比如我) review 到了其他并行的开发或者是之前的改动。
三:review 由于不是使用多模型对抗性审查,且上下文并未分离,导致 review 最终的审查不够严格,客观,全面。
Flow 在这做了很多精细的设计。其中一些细节包括:
- 通过仔细设计的拷问提示词,确保用户与 AI 意图的真正对齐。
- 优化了上下文的提取,将用户意图、近期对话、工具结果、修改过的文件作为参考资料,但明确说明这是用户与执行模型的对话,保持客观严谨;审查模型会客观地进行只读审查和运行测试。
- 审查如果被否决、执行模型继续完成时,当次数达到任何双数轮时,都会有更强大的顾问模型介入来调整方向,防止死循环。
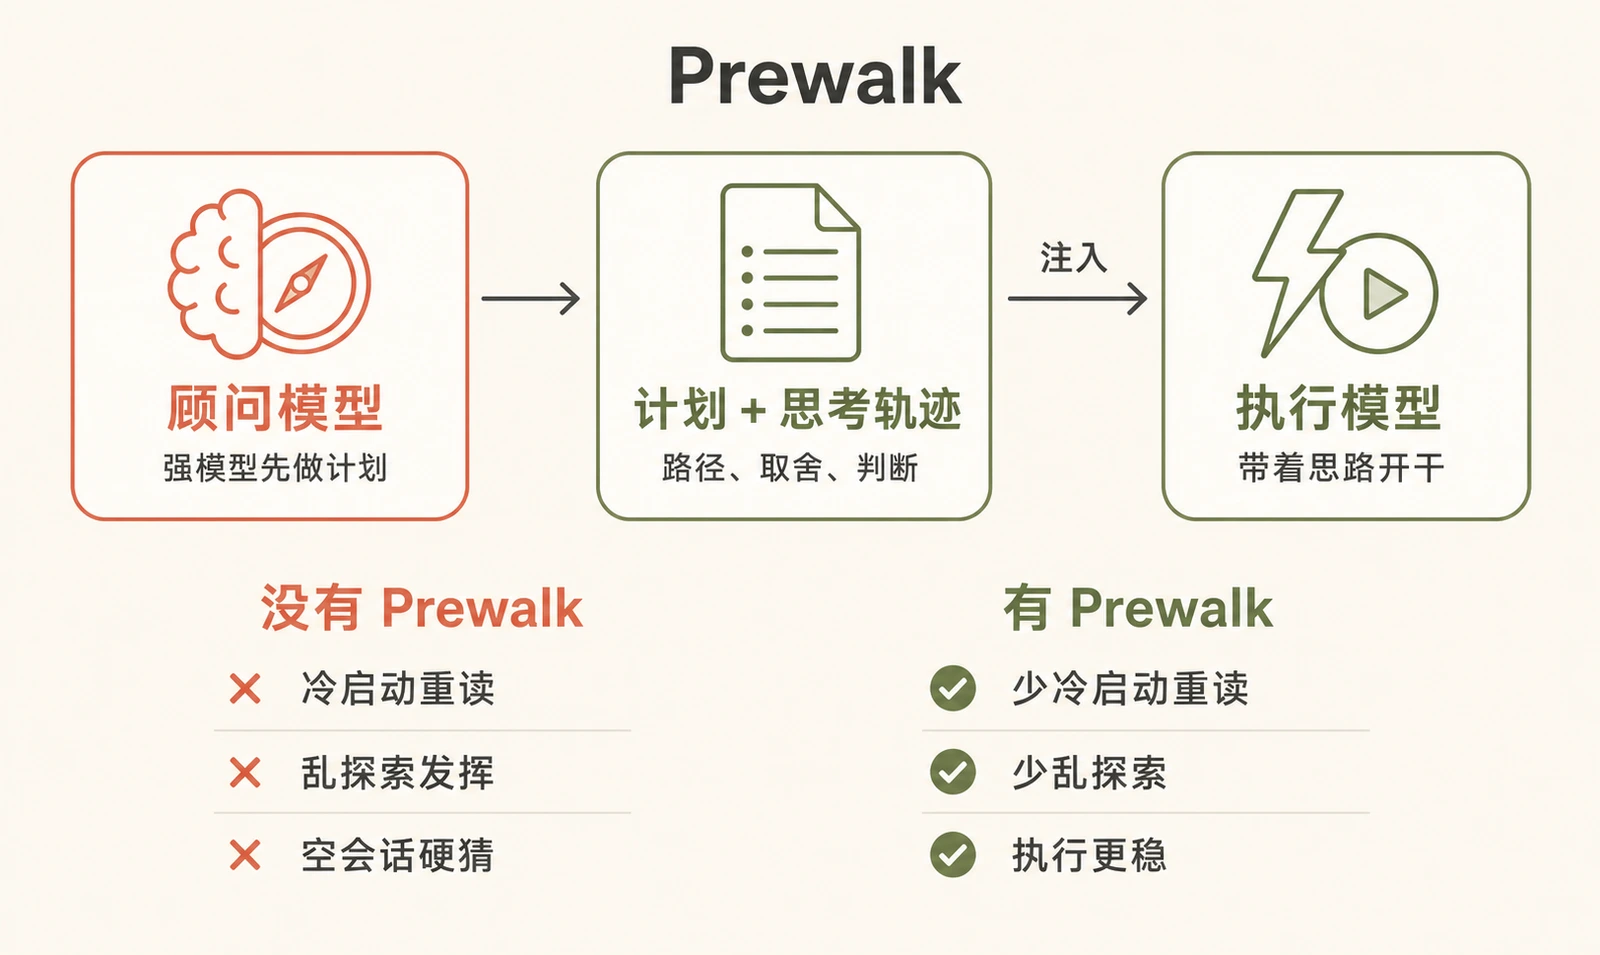
- 结合了 Prewalk 的思想:你只需要在最开始用强大的顾问模型进行计划设计,顾问模型的思考精髓会注入到之后的执行模型中,省去了非常多的探索步骤,并极高地提升了执行模型的智力——因为强大模型的思路已经印在了他们的脑海中,他们不再容易自己乱探索和发挥,而是循优质的思路继续往下走。此方案优势在来源文章中有具体的体现,来源:stencil.so/blog/prewalk
- Flow 在可视化上也做了努力。当 Flow 生成计划后,通过模板生成清晰的网页报告,你不再需要盯着密麻的终端,只需网页就能看到执行的情况;而且你可以在你的局域网或是 Tailscale 中,通过手机或任意设备来随时查看 Flow 的工作情况。且在以后能作为留档的依据。
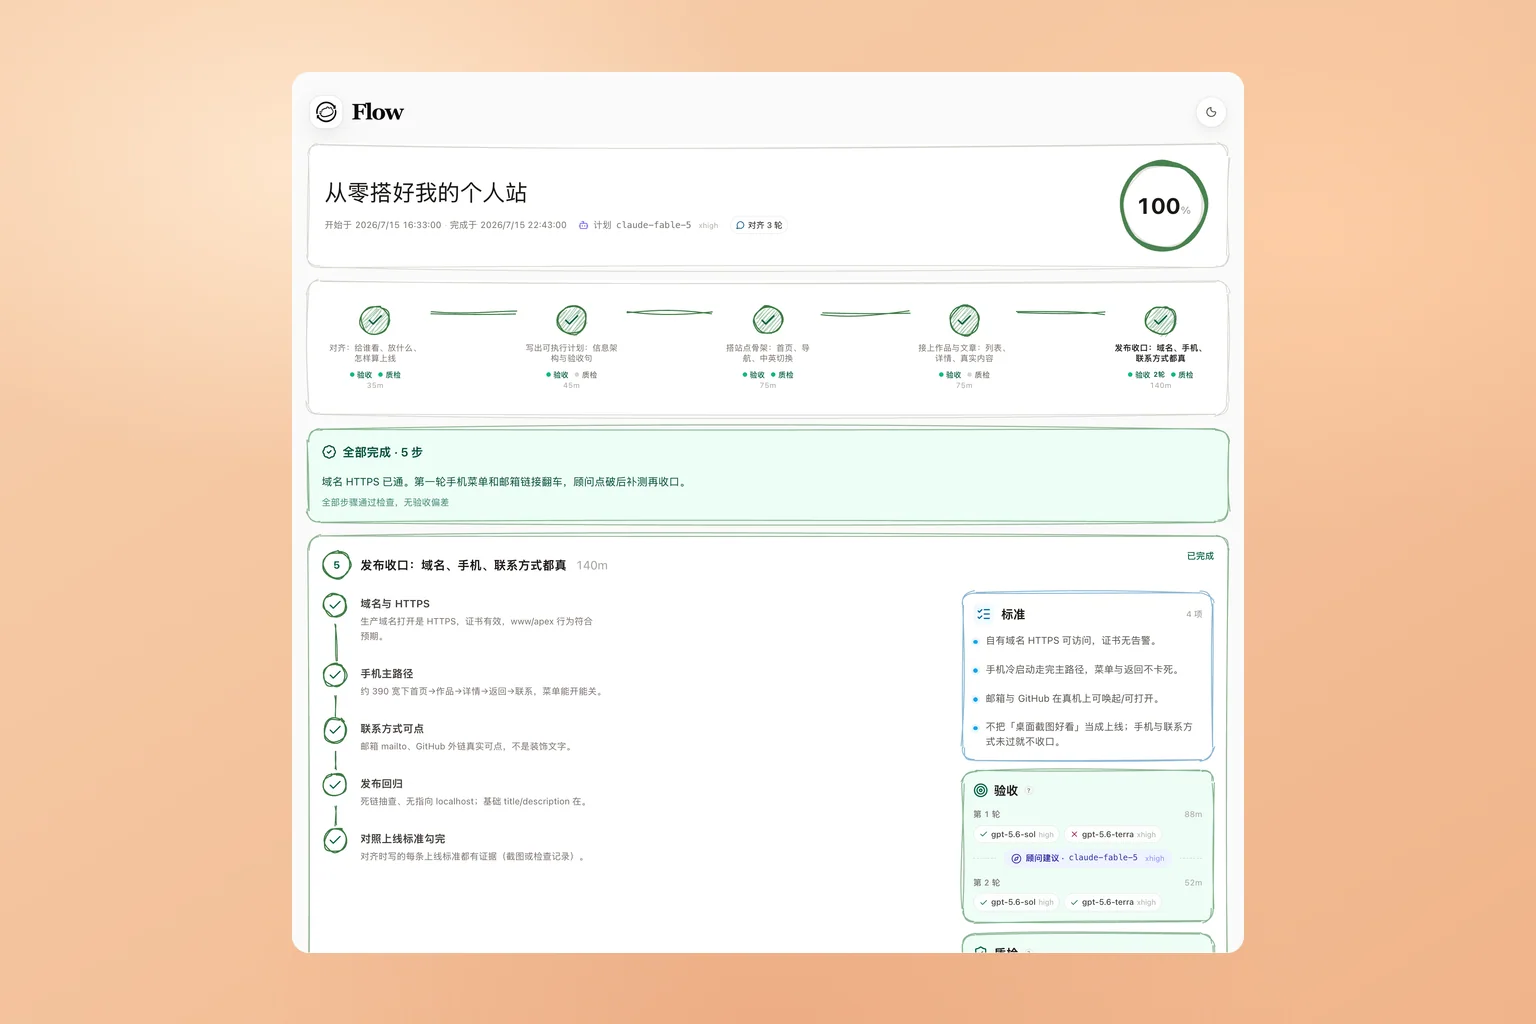
现在你随时可以使用 Flow,只需要在安装了 Pi 的机器中用一行 npm 命令安装,配置好角色的模型后,使用 /flow 直接开始。
我个人最爱的搭配是: 顾问:Fable / Kimi K3 执行:GPT 5.6 sol Xhigh 审查:GPT 5.6 sol high + Terra xhigh + Sonnet 5 high
尽情享用! 用循环构建你的一切,发出任务之后喝咖啡去。